Notepad++ plugin
Volledige conversiematrix
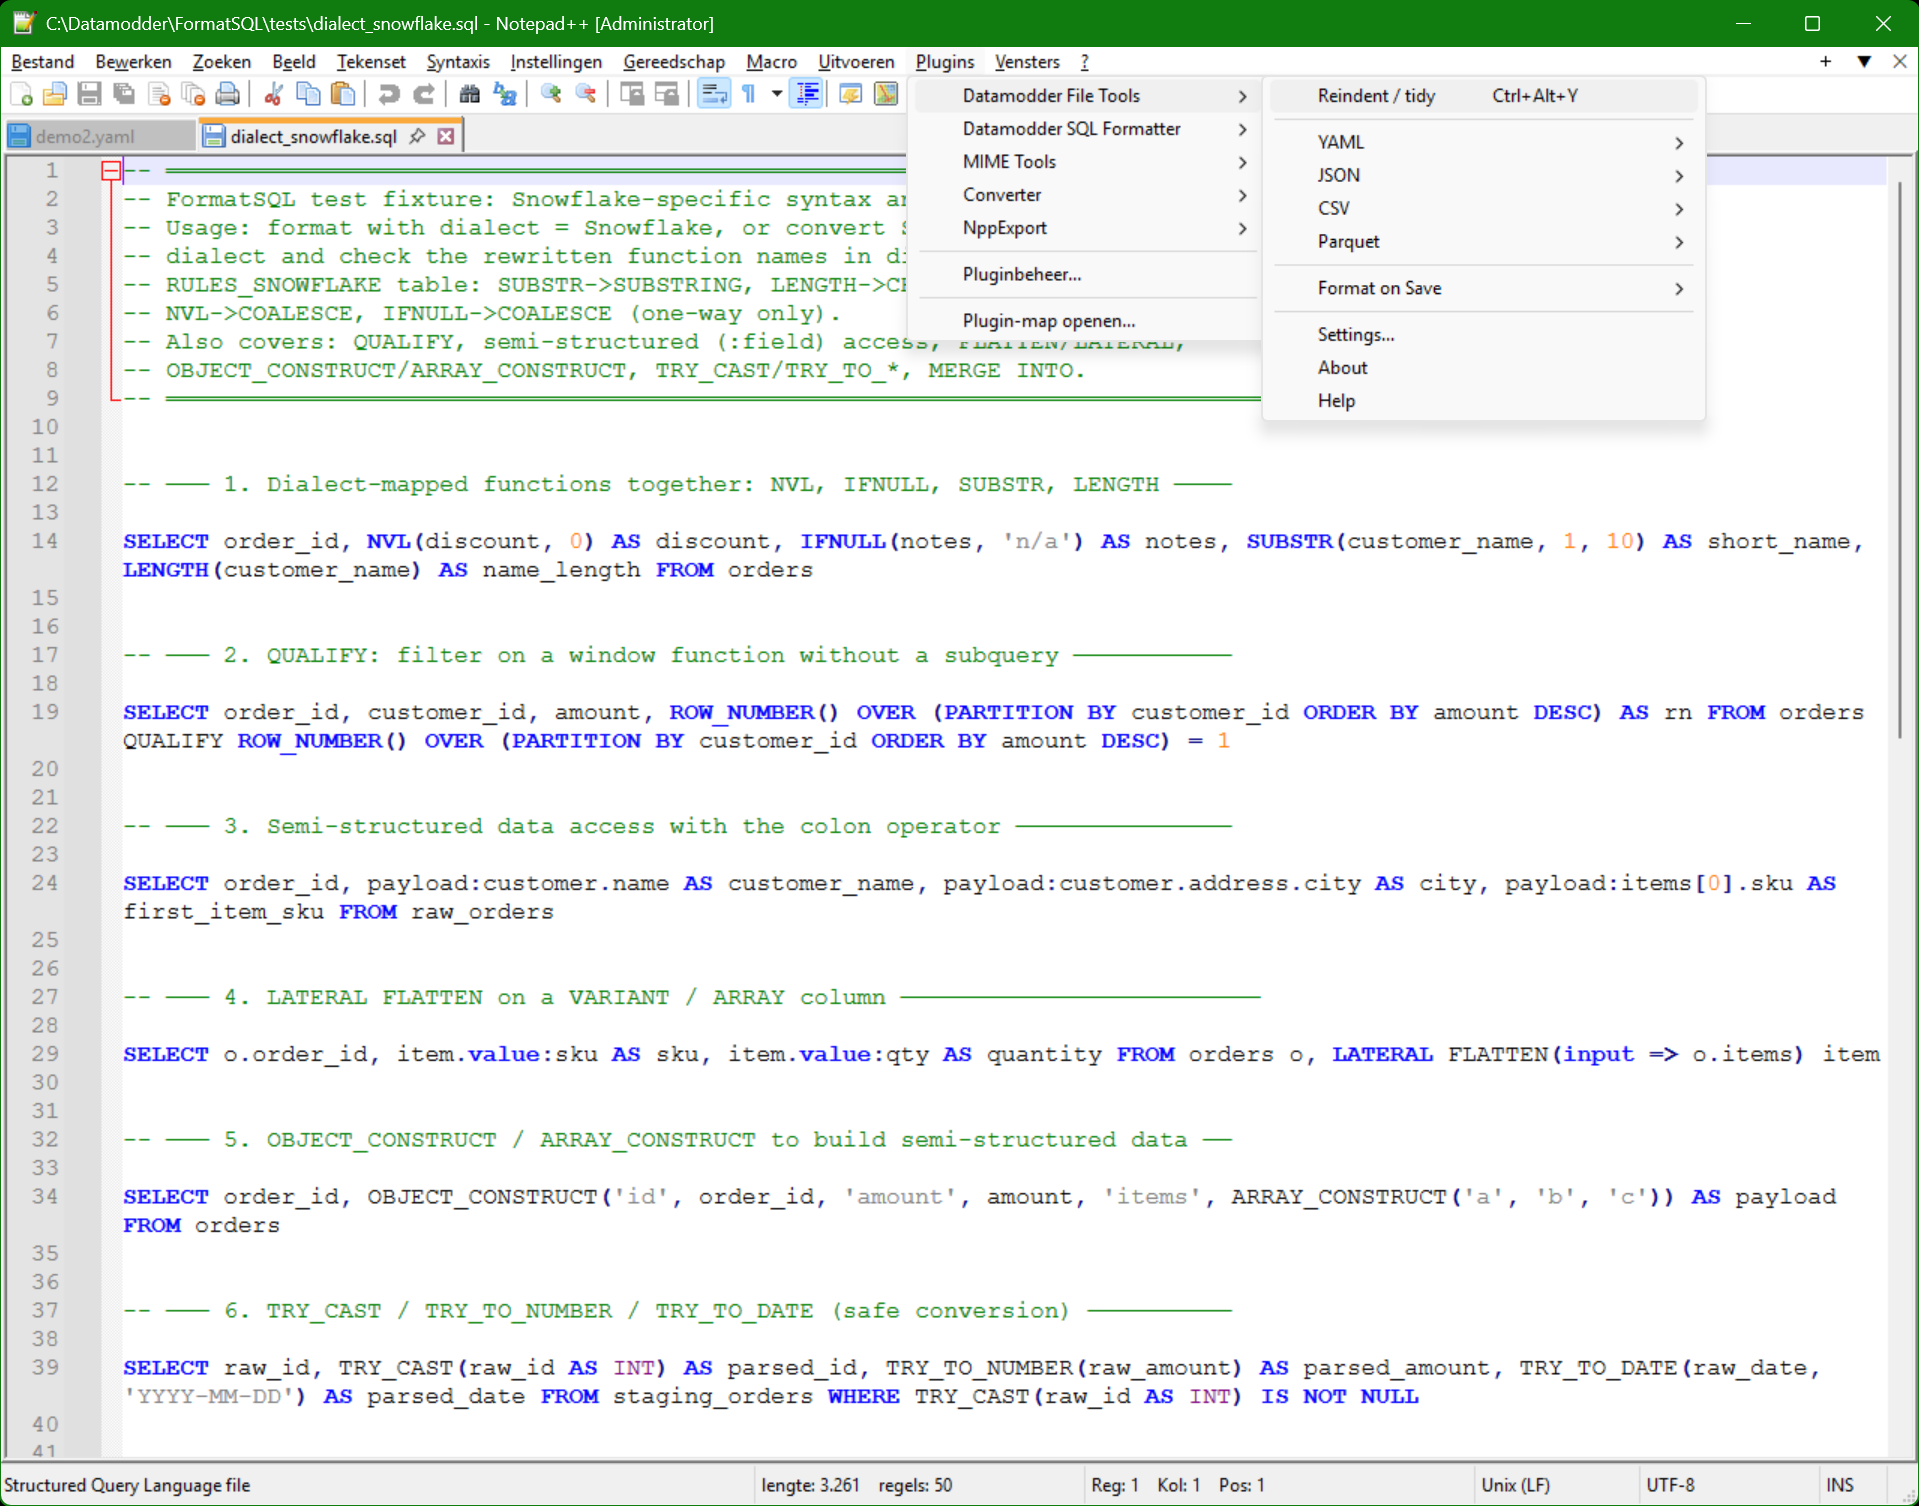
Elk formaat-submenu (YAML, JSON, CSV, Parquet) bevat een conversie naar elk ander formaat — je hoeft nooit zelf te bedenken via welke tussenstap je van CSV naar Parquet komt. YAML routeert intern via JSON (met libyaml), en alles wat Parquet raakt gaat via het lokaal geïnstalleerde duckdb.exe.
YAML → JSON, met behoud van type en structuur
Mappings worden objecten, lijsten worden arrays, en getallen/booleans/null blijven hun eigen JSON-type in plaats van strings te worden. De omgekeerde conversie (JSON → YAML) werkt net zo — handig als je een API-response wil opslaan als leesbare configuratie.
Voor
app:
  name: orders-service
  retries: 3
  active: true
  tags:
    - billing
    - orders
Na
{
  "app": {
    "name": "orders-service",
    "retries": 3,
    "active": true,
    "tags": ["billing", "orders"]
  }
}
CSV ↔ Parquet via duckdb.exe
Parquet is een binair, kolomgeoriënteerd formaat — niet iets om met de hand te bewerken. De plugin start duckdb.exe als los proces, laat het de conversie uitvoeren, en ruimt de tussenstappen zelf op. Je krijgt een nieuw .parquet-bestand (voor CSV/JSON/YAML → Parquet) of een leesbare preview-tab (voor Parquet → alles anders) zonder dat je zelf een terminal opent.
Veelgestelde vragen
Wat als duckdb.exe niet op mijn systeem staat?
Alleen de Parquet-conversies en -preview hebben duckdb.exe nodig; YAML, JSON en CSV werken onderling zonder die afhankelijkheid. Op het Parquet-tabblad van de instellingen kun je een pad opgeven, of het leeg laten zodat de plugin zelf zoekt op je PATH en naast de plugin-DLL.
Blijven kolomtypes behouden bij CSV → Parquet?
duckdb.exe leidt het type van elke kolom af tijdens de conversie (getal, datum, tekst, enzovoort), net zoals het dat zou doen bij een reguliere CSV-import in DuckDB.